REAL-TIME AUDIO ENGINE
JUCE 实时音频引擎
专业音频行业的通用底座,SHOW-0 的心脏。
JUCE 是国际专业音频领域广泛采用的开发框架,众多知名音频品牌的效果器插件与音乐制作软件,都构建在它之上。
SHOW-0 以 JUCE 为核心打造实时音频引擎:伴奏、人声、和声运行在同一个时钟上,采样级同步;切换演唱模式、切换人声版本,一拍不差。
专业级音频内核采样级同步毫秒级延迟
从 AI 制作到实时演唱,九个模块各司其职,全部由原生代码驱动。点击线路图上的模块,查看每一环的技术细节。
专业音频行业的通用底座,SHOW-0 的心脏。
JUCE 是国际专业音频领域广泛采用的开发框架,众多知名音频品牌的效果器插件与音乐制作软件,都构建在它之上。
SHOW-0 以 JUCE 为核心打造实时音频引擎:伴奏、人声、和声运行在同一个时钟上,采样级同步;切换演唱模式、切换人声版本,一拍不差。
不套网页壳,不带 Python,纯原生打造。
SHOW-0 由 C++20 原生编写,直接运行在 Windows 之上,没有浏览器内核,也没有脚本运行时的负担。
界面采用 Qt 6 —— 汽车座舱、医疗设备、工业控制等专业领域长期使用的界面框架,由显卡全程渲染。连续直播数小时,依然轻快稳定。
你的电脑,就是你的 AI 工作室。
推理基于微软 ONNX Runtime —— 众多企业级 AI 产品采用的推理引擎。NVIDIA、AMD、Intel 显卡均可加速,没有独立显卡同样可以运行。
显存不足时自动调整精度与分块,任务不中断。人声分离、AI 翻唱、改词演唱,全部在本地完成。
导入一首歌,得到一首可以直接开唱的作品。
从干声识别、人声分离、和声分离、去混响,到 AI 翻唱、人声收尾、去 AI 痕迹、逐字歌词,整条流程自动完成。
制作在后台独立进行,播放和直播互不打扰。成品是伴奏、原声、和声、AI 人声四轨分离的歌曲包。
一段清唱,练出只属于你的声音。
上传清唱干声,在云端专业显卡上训练你的个人音色模型,支持 So-VITS、DDSP、RVC 三种主流架构。
算力按需启动、按实际用量计费;训练完成的模型只发给你本人。
软件与直播工程之间的专用通道。
声音经由共享内存直达直播工程,不经网络,也不经虚拟声卡。
整条通道以声卡时钟为准实时同步,连续直播数小时,人声与伴奏始终严丝合缝。
演唱模式,一键掌控。
Gate 是 SHOW-0 为 Studio One 直播工程打造的 VST3 插件,与主程序共享同一套 JUCE 音频内核。
AI 跟唱、AI 唱歌、混响说话、普通说话四种模式一键切换;智能切换会在唱歌与说话之间自然衔接。
所听,即所播。
你在耳机里听到的,与送进直播间的声音,出自同一个引擎、同一个时钟。
经 ASIO / WASAPI 低延迟输出,每一次开口都有及时、清晰的反馈。
观众听到的,就是成品。
人声、伴奏、混响在 Studio One 里完成最终混音,再送进直播软件。
兼容常用的直播软件与直播伴侣,接上即可开播。
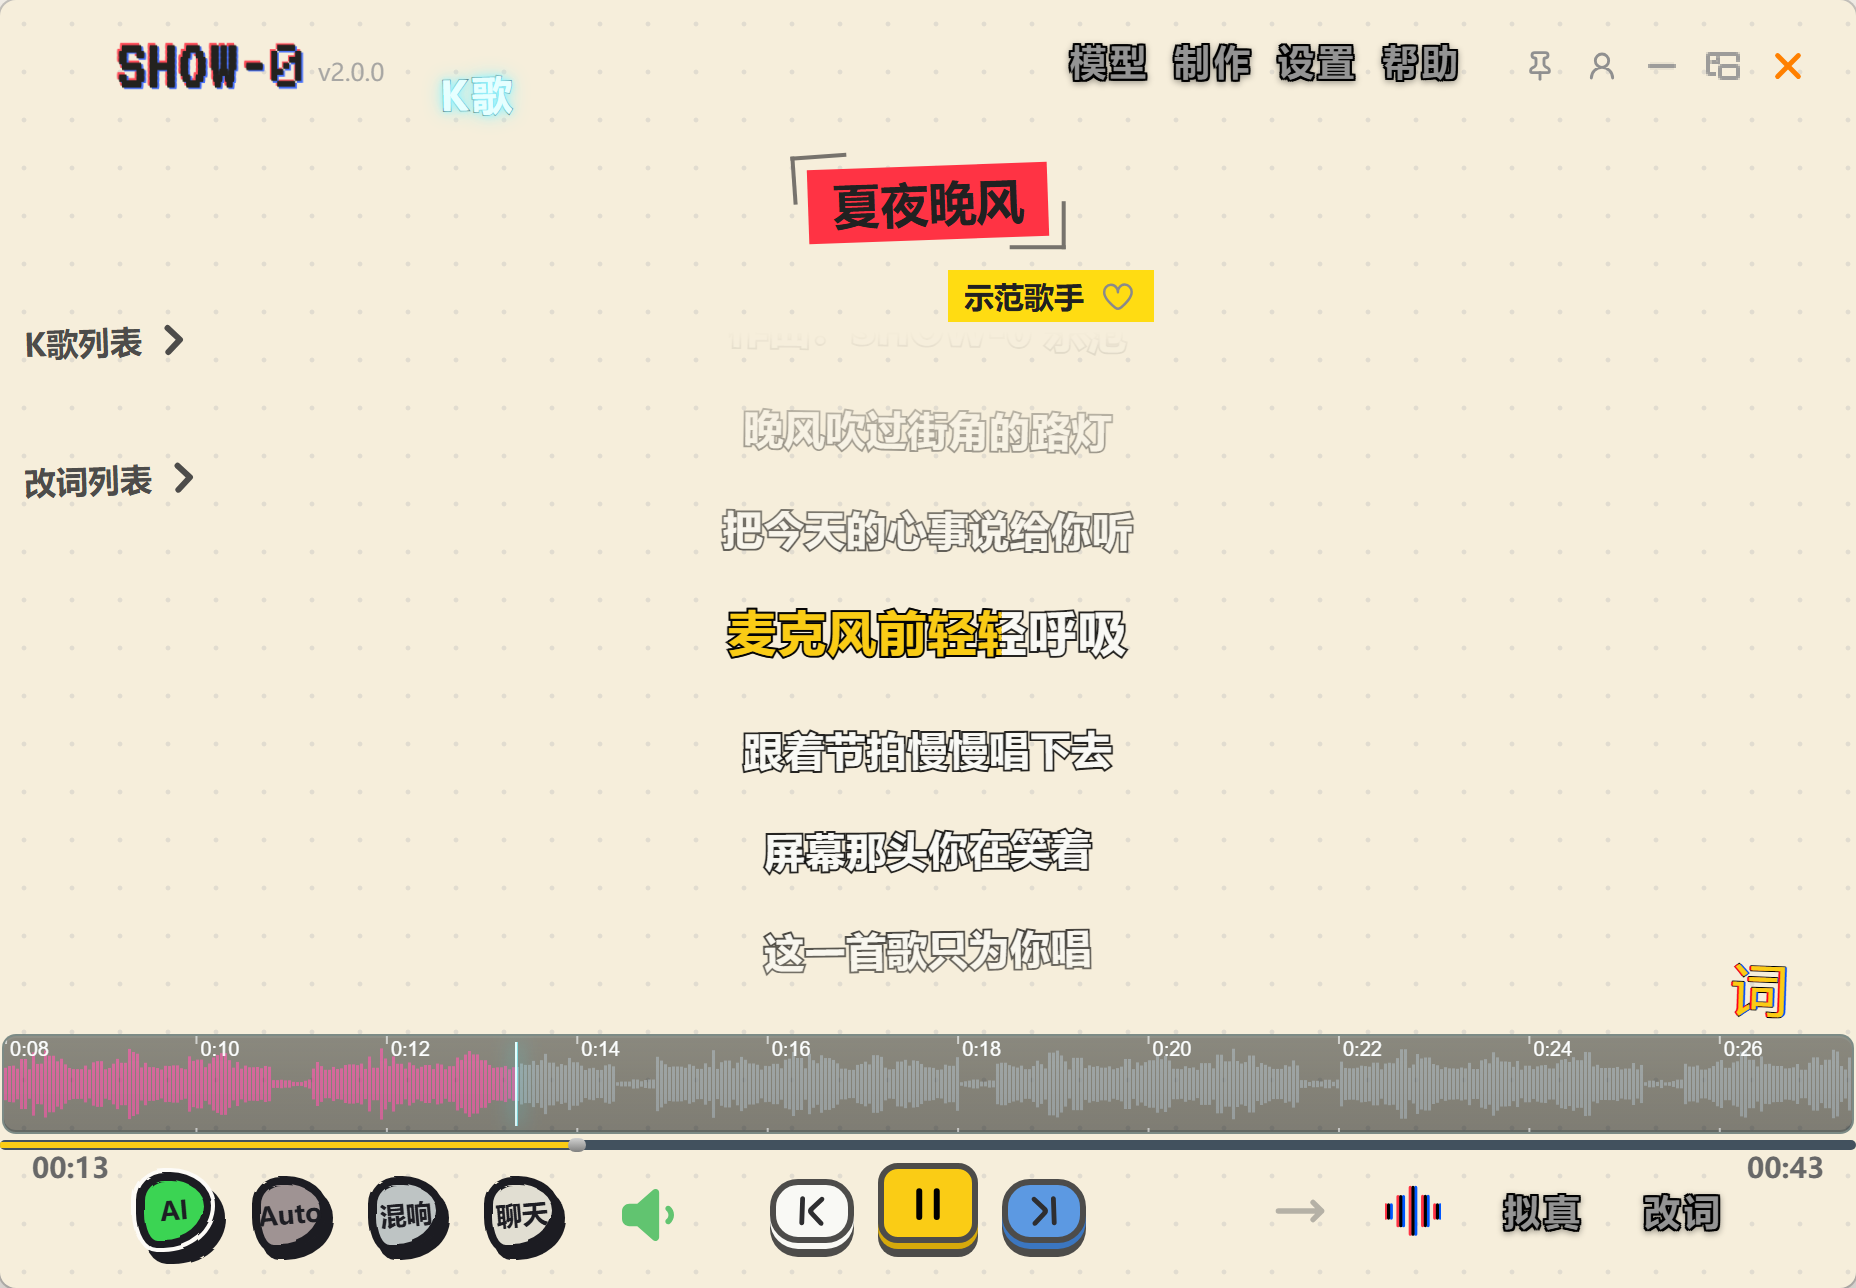
支持导入本地歌曲,完成分轨、去混响、AI 翻唱、音高调整、响度匹配和去 AI 痕迹处理,并生成歌曲包。也可以导入自行准备的伴奏、人声、原声、和声及歌词,建立自己的曲库。
K 歌模式支持多音轨同步播放,以及人声、伴奏等音轨的独立音量控制;音乐模式提供循环、随机、单曲循环和单曲播放。
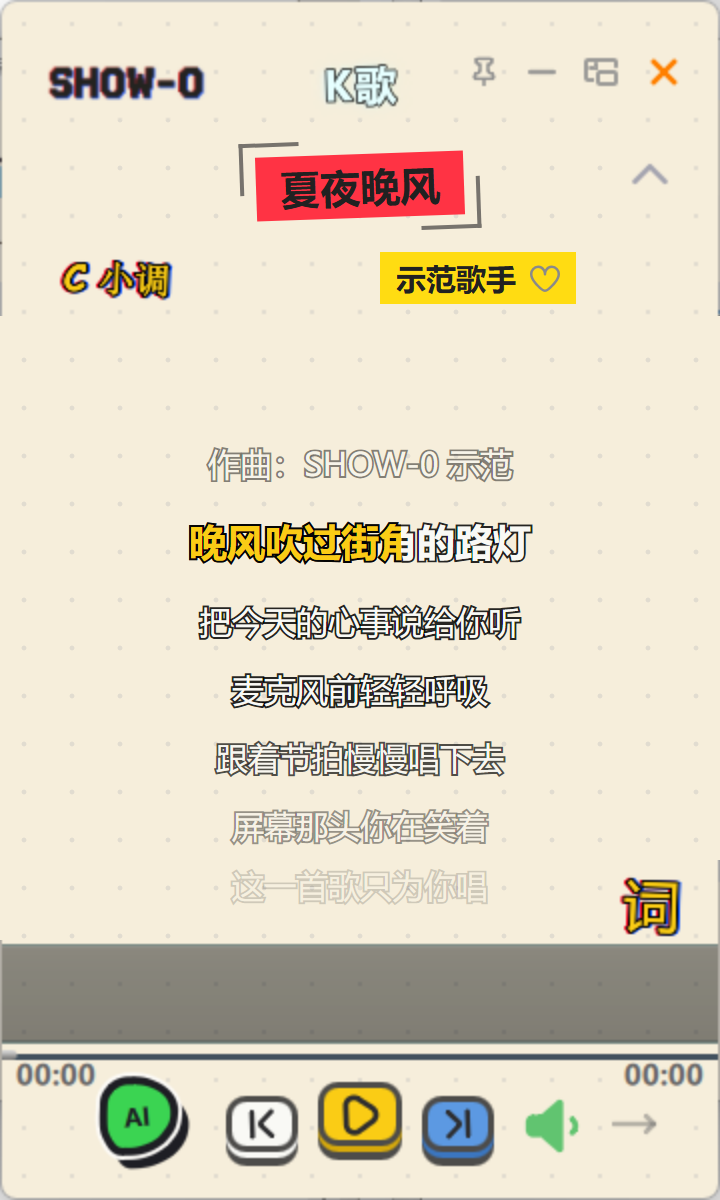
支持逐字歌词、翻译歌词显示和重新匹配歌词;桌面歌词支持字号、配色与横竖排等设置。
选择歌词句段、输入新内容、生成试听并保存独立改词轨;人声编辑支持选定范围调节音量、淡入和淡出。
按设定比例选择句子进行局部音高变化,并保存为独立拟真音轨,可在制作时启用,也可对已有歌曲单独生成。
支持 So-VITS、DDSP 和 RVC(v2)模型的导入、选择和参数管理,方便切换不同音色进行制作。
支持歌单、置顶、歌曲包重命名、转移和批量导入;环境音与按键音效可自行添加。
主界面、小屏、悬浮播放条三种显示模式,歌词跟随统一播放进度,桌面歌词可以单独显示。